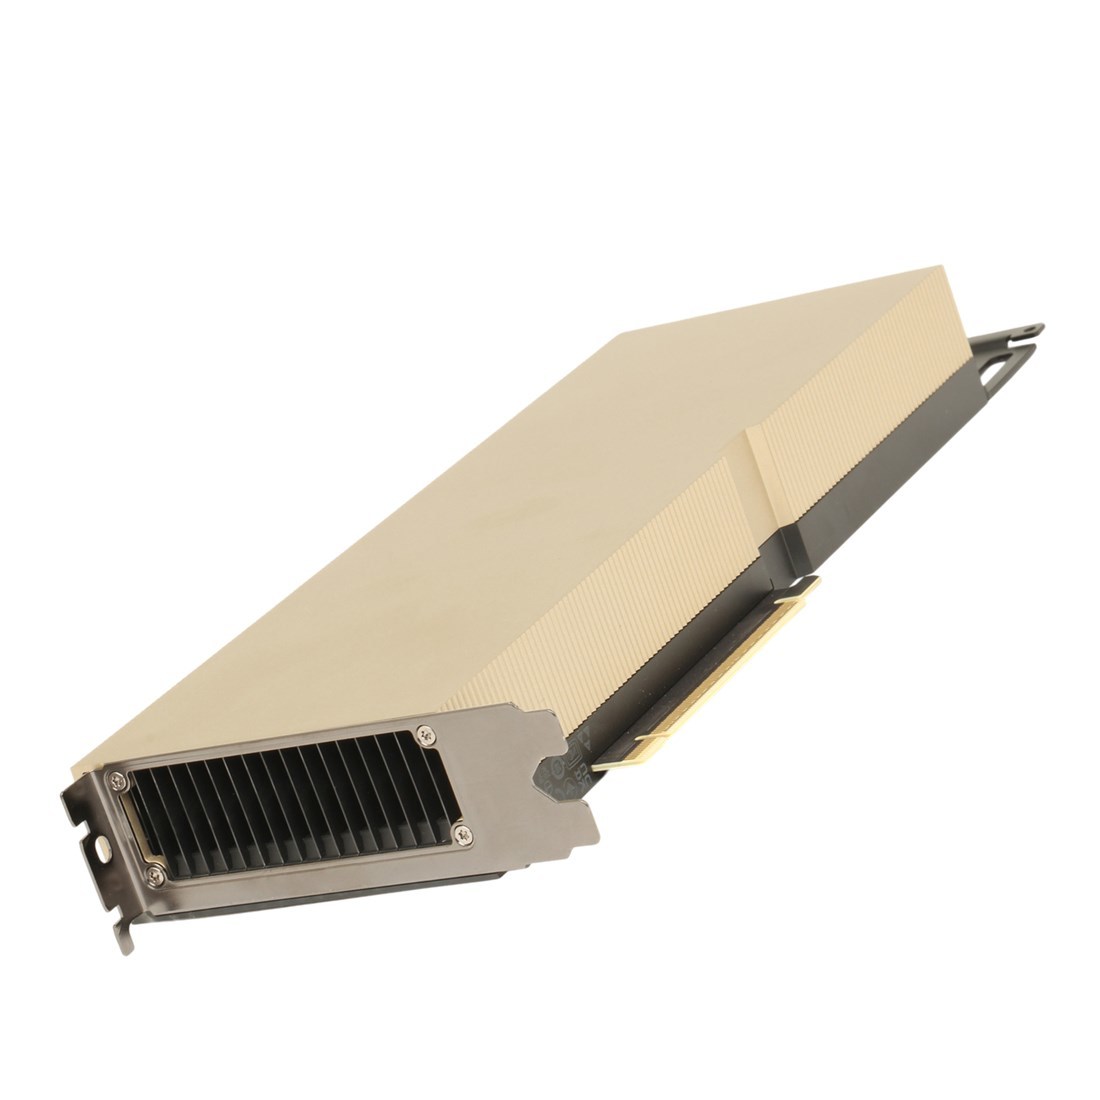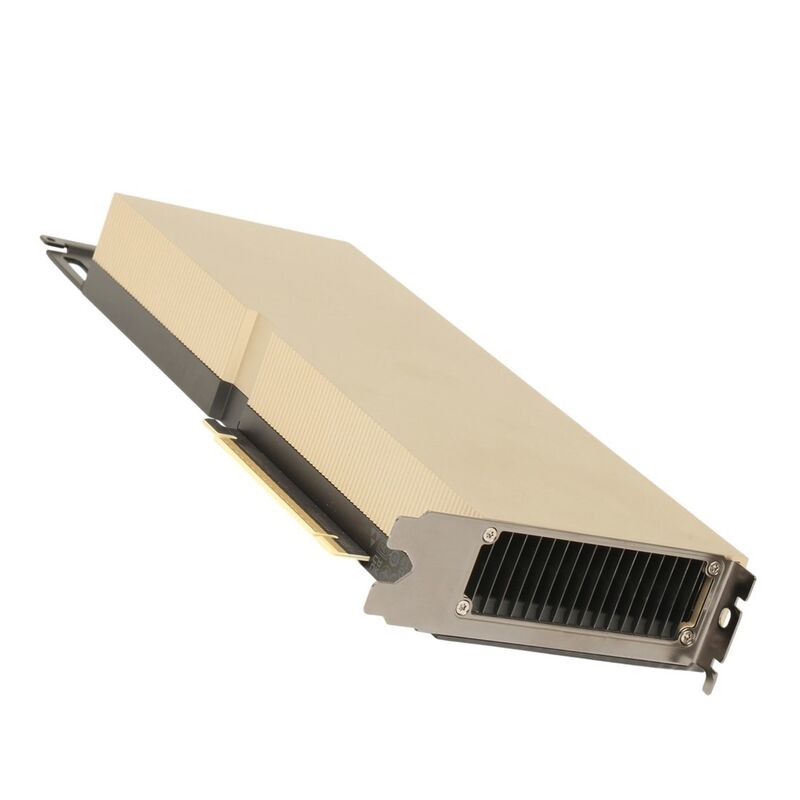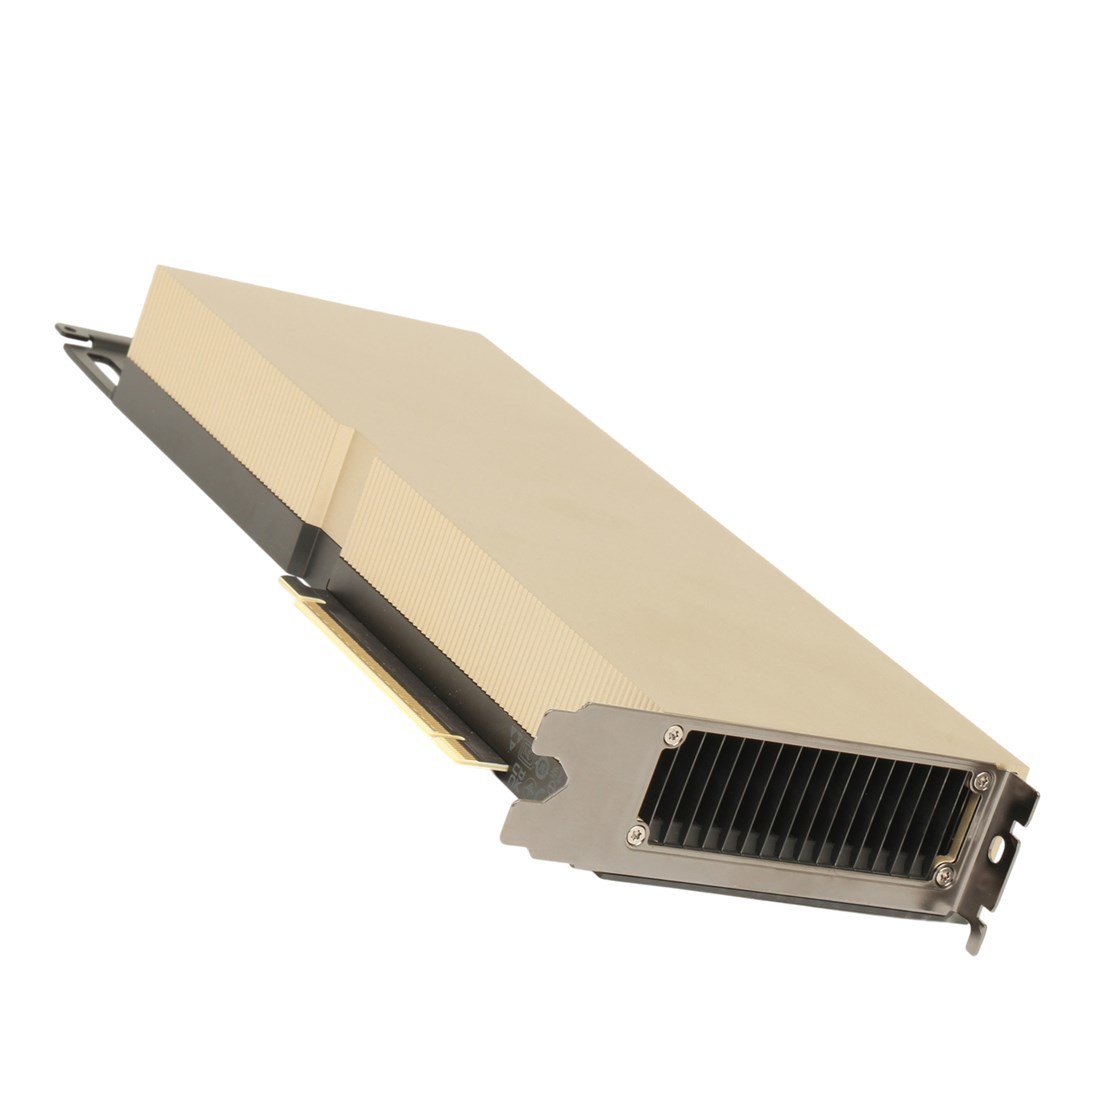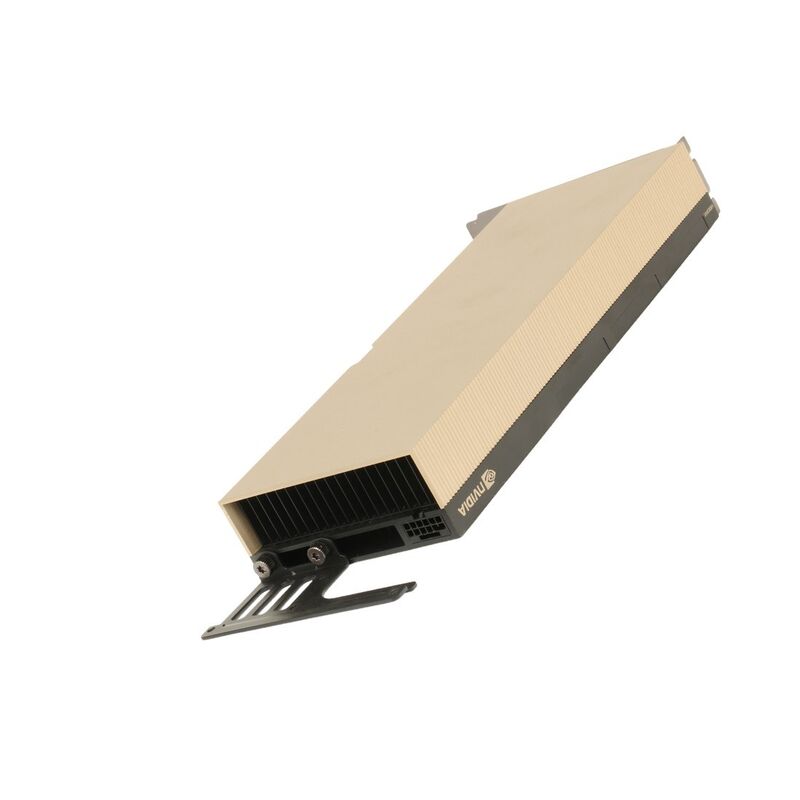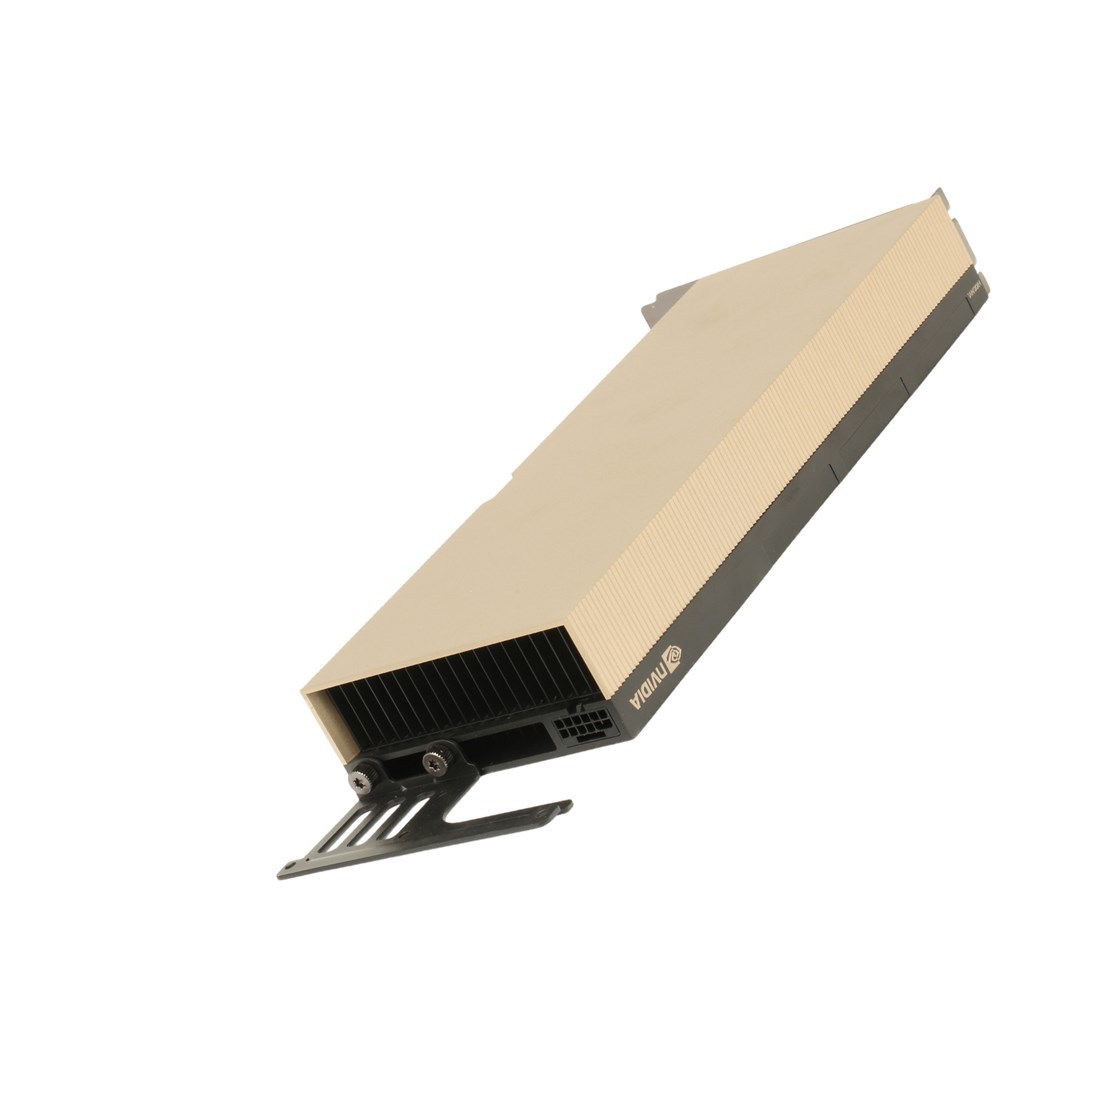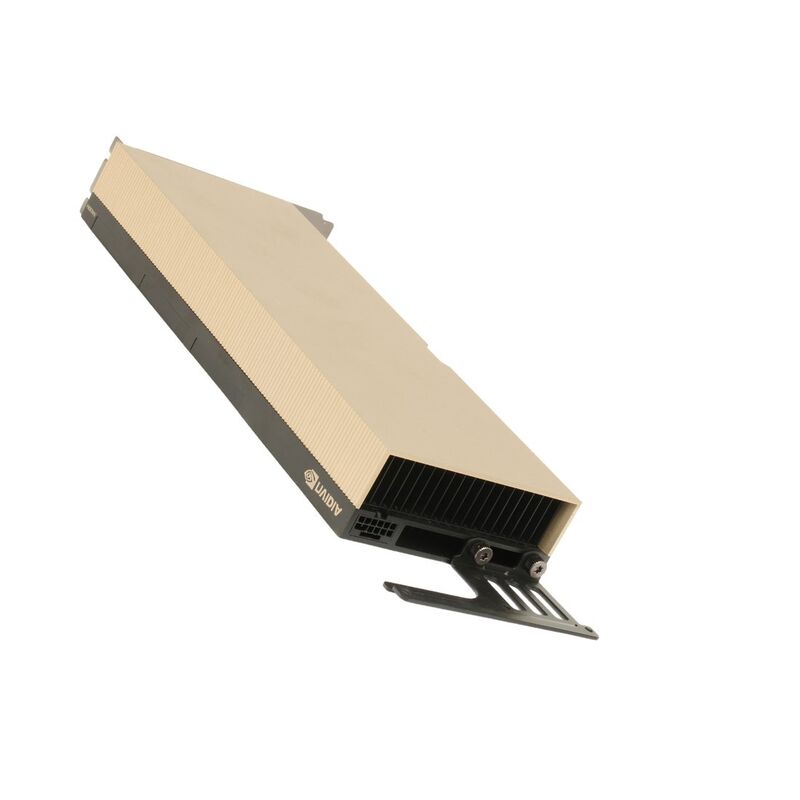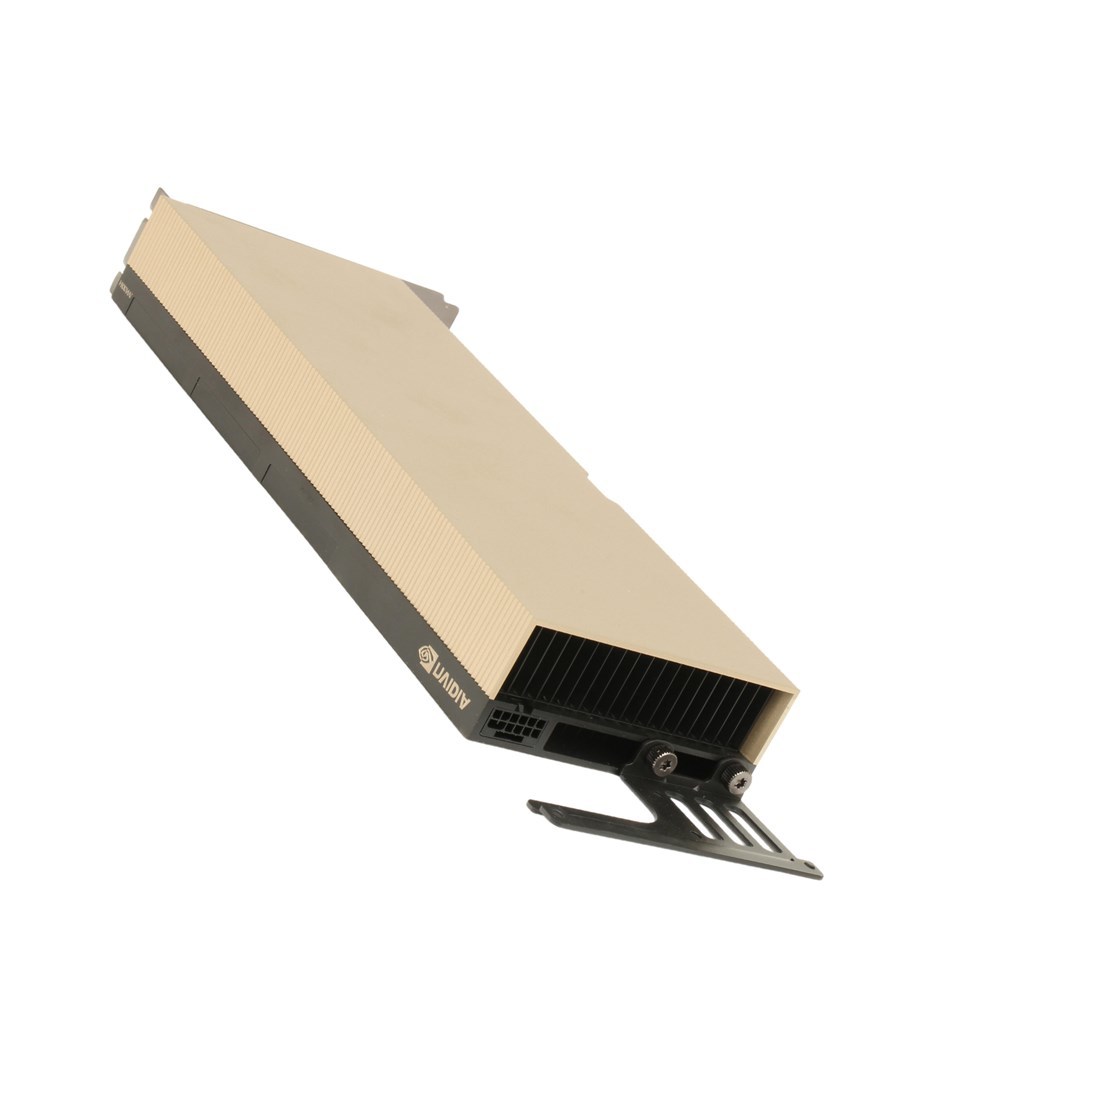
| 熱解決: | 受け身 | 機械的フォームファクター: | フルハイト、フルレングス (FHFL) 10.5 インチ、デュアルスロット |
|---|---|---|---|
| GPUクロック: | ベース: 1,080 MHz ブースト: 1,785 MHz | パフォーマンス状態: | P0 |
| PCIの明白なインターフェイス: | PCI Express Gen5 x16; Gen5 x8; Gen4 x16 レーンおよび極性反転をサポート | マルチインスタンス GPU (MIG): | サポートされています (7 つのインスタンス) |
| 記憶時計: | 2,619MHz | メモリの種類: | HBM3 |
| メモリサイズ: | 94GB | 記憶バス幅: | 6,016ビット |
NVIDIA® H100 NVL Tensor Core GPUは、高いコンピューティング密度、高いメモリ帯域幅、高いエネルギー効率、そして独自のNVLinkアーキテクチャにより、LLM推論に最も最適化されたプラットフォームです。また、AI、データ分析、および高性能コンピューティング(HPC)アプリケーション向けの、世界で最も高性能な弾力性のあるデータセンターを支えるために、前例のない高速化を実現します。NVIDIA H100 NVL Tensor Coreテクノロジーは、幅広い数学精度をサポートし、あらゆるコンピューティングワークロードに対応する単一のアクセラレータを提供します。NVIDIA H100 NVLは、倍精度(FP64)、単精度(FP32)、半精度(FP16)、8ビット浮動小数点(FP8)、および整数(INT8)のコンピューティングタスクをサポートします。
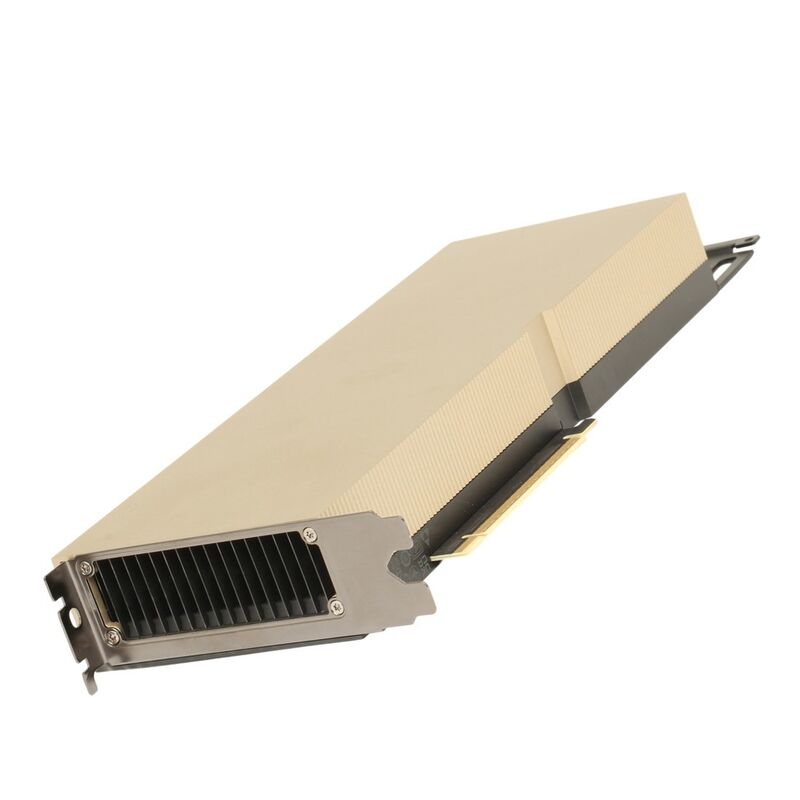
NVIDIA H100 NVLカードは、NVIDIA Hopper™アーキテクチャをベースにしたデュアルスロット10.5インチPCI Express Gen5カードです。冷却にはパッシブヒートシンクを使用しており、カードを熱的制限内で適切に動作させるためにはシステムエアフローが必要です。NVIDIA H100 NVLは、最大熱設計電力(TDP)レベル400Wまで制約なく動作し、最も高速な計算速度と最高のデータスループットを必要とするアプリケーションを加速します。NVIDIA H100 NVLは、毎秒約4,000ギガバイト(GBps)という、世界で最も高いPCIeカードメモリ帯域幅を初めて実現しました。これにより、最大のモデルと最も大規模なデータセットに対するソリューションまでの時間を短縮します。
NVIDIA H100 NVLカードは、マルチインスタンスGPU(MIG)機能を備えています。これは、GPUを最大7つのハードウェア分離GPUインスタンスにパーティション化するために使用でき、弾力性のあるデータセンターが変化するワークロードの要求に動的に適応できるようにする統合プラットフォームを提供します。また、最小から最大のマルチGPUジョブまで、適切なサイズのコンピューティングリソースを割り当てることができます。NVIDIA H100 NVLの汎用性により、ITマネージャーはデータセンター内のすべてのグラフィックス処理ユニット(GPU)の利用率を最大化できます。
NVIDIA H100 NVLカードは、3つのNVIDIA® NVLink®ブリッジを使用します。これらは、NVIDIA H100 PCIeカードで使用されるものと同じです。これにより、2つのNVIDIA H100 PCIeカードを接続して、600 GB/sの双方向帯域幅、またはPCIe Gen4の10倍の帯域幅を実現し、大規模ワークロードのアプリケーションパフォーマンスを最大化できます。
![]()